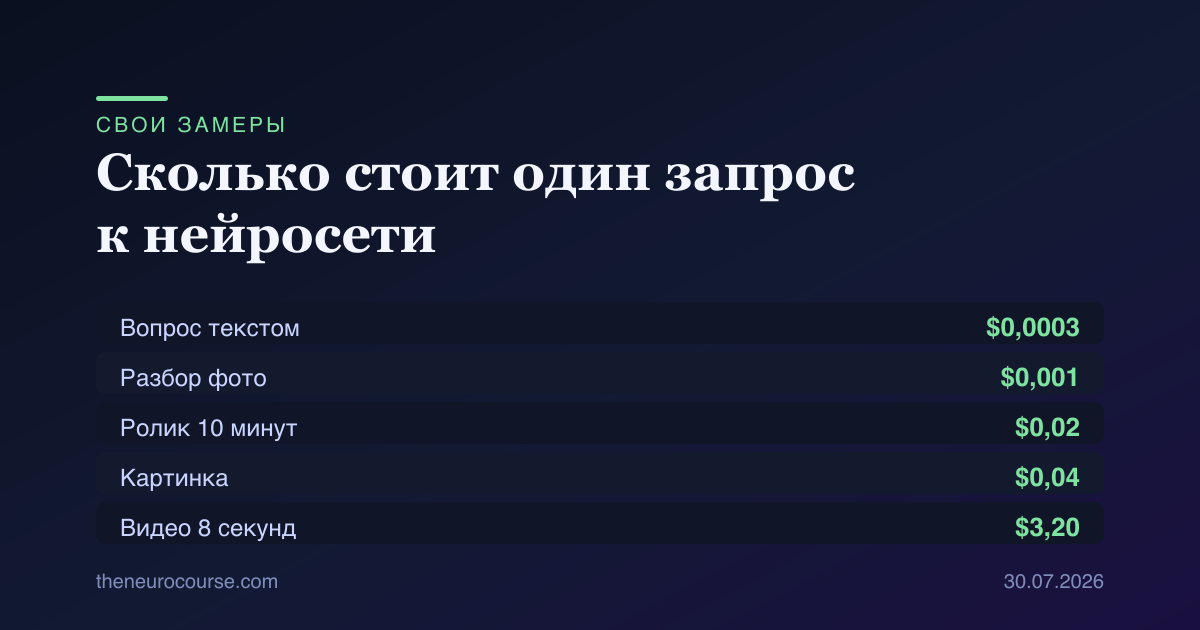
Quanto custa um pedido de IA: medimos nove operações
A versão resumida: em 30 de julho de 2026, executamos nove tipos de solicitações no Google Vertex AI e registramos as contagens de tokens diretamente das respostas da API. A principal descoberta: ler é barato para uma IA, criar é caro, e a diferença chega a mil vezes. Assistir a um vídeo do YouTube de dez minutos custa dois centavos. Gerar oito segundos de vídeo custa três dólares e vinte centavos. Mesma tecnologia, mesma conta, mas operações de natureza completamente diferente — e você não pode planejar um orçamento sem entender essa diferença.
Como medimos
Não de calculadoras em páginas de marketing nem de promessas em blogs de fornecedores. Cada solicitação foi para o Vertex AI na conta de serviço do nosso projeto, e de cada resposta pegamos o bloco usageMetadata — onde o próprio modelo informa quantos tokens seu input custou e quantos sua resposta custou.
Em seguida, multiplicamos pelos preços publicados pelo Google em 30 de julho de 2026 para a família Gemini 2.5 Flash-Lite: $0,10 por milhão de tokens de entrada (texto, imagens, vídeo), $0,30 por milhão de tokens de entrada de áudio e $0,40 por milhão de tokens de saída. Os preços de geração de vídeo vêm da lista do Veo 3.1: $0,40 por segundo no modo padrão.
O método importa porque permite que você o repita: os mesmos números estão na resposta de qualquer solicitação que você fizer, se você olhar em usageMetadata.
A tabela: o que custa o quê
| Operação | O que acontece | Custo por execução |
|---|---|---|
| Uma pergunta de texto | ~300 tokens de entrada, ~500 de saída | $0,0003 |
| Ler uma foto | imagem mais uma resposta curta | $0,001 |
| Transcrever 30s de fala | áudio custa três vezes o texto | $0,0008 |
| Ler um parágrafo em voz alta | síntese de fala | $0,0006 |
| Assistir a um vídeo de 3 minutos | 51k tokens | $0,006 |
| Assistir a um vídeo de 10 minutos | 171k tokens | $0,02 |
| Gerar uma imagem | 1.290 tokens de saída | $0,04 |
| 8s de vídeo, modo rápido | cobrado por segundo | $0,64 |
| 8s de vídeo, modo padrão | cobrado por segundo | $3,20 |
A descoberta: assistir é mais barato que criar
Compare duas linhas. Analisar um vídeo de dez minutos de outra pessoa: dois centavos. Gerar oito segundos do seu próprio: três dólares e vinte centavos. Isso é 160 vezes mais por setenta e cinco vezes menos segundos.
A razão é como a cobrança funciona. Tudo o que você envia ao modelo são tokens de entrada — a coisa mais barata na lista de preços. Tudo o que ele produz é saída, e a saída custa várias vezes mais. Com o Flash-Lite, a entrada é $0,10 por milhão e a saída é $0,40 — quatro vezes mais. A geração de imagens e vídeos é cobrada separadamente novamente, em taxas completamente diferentes.
Daí a regra que economiza mais dinheiro: encurte a resposta, não a pergunta. Uma linha dizendo "responda em um parágrafo" reduz sua conta mais do que reduzir sua pergunta pela metade. A frase mais cara que você pode escrever para um modelo é "explique em detalhes, com todos os exemplos".
Vídeo, segundo a segundo
Medimos isso separadamente, cortando um clipe em diferentes durações. O modelo conta o vídeo como 258 tokens por segundo de filmagem e 25 tokens por segundo de áudio. A relação é estritamente linear — cinco segundos resultaram em 1.290 tokens, dez segundos resultaram em exatamente 2.580.
| Duração | Tokens | Custo para analisar |
|---|---|---|
| 5 segundos | 1.415 | $0,0002 |
| 1 minuto | 17.000 | $0,002 |
| 5 minutos | 85.000 | $0,010 |
| 10 minutos | 171.000 | $0,020 |
O que isso significa na prática: analisar vídeo não é um luxo. Extrair o conteúdo de uma palestra de uma hora custa cerca de doze centavos. Seu próprio tempo para formular a tarefa custará mais.
Por que você ainda precisa fazer as contas
Uma única solicitação custa uma fração de centavo, o que cria a impressão de que não há nada a ser contado. Essa impressão está errada por duas razões.
Primeiro: uma conversa fica mais cara a cada mensagem. O modelo não se lembra das interações anteriores — para que ele siga o contexto, toda a troca é enviada novamente a cada solicitação. Sua décima mensagem arrasta as nove anteriores, e todas elas contam como entrada novamente. Você continua escrevendo respostas igualmente curtas enquanto a conta aumenta sozinha.
Segundo: algumas línguas custam aproximadamente o dobro do inglês. O modelo não conta letras nem palavras, mas tokens — pedaços de texto. O inglês se divide em pedaços maiores: um token é aproximadamente quatro caracteres, enquanto em muitas outras línguas está mais próximo de dois. O mesmo pensamento custa uma vez e meia a duas vezes mais.
O que fazer a respeito
- Limite explicitamente o tamanho da resposta. "Três frases", "um parágrafo", "uma lista de cinco" — isso é economia direta, não preciosismo estilístico.
- Comece um novo chat para uma nova tarefa. Uma conversa longa e tudo-em-um custa mais do que um chat novo com a mesma pergunta — e funciona melhor, porque o contexto obsoleto para de atrapalhar.
- Não gere o que você pode encontrar. Ler um clipe ou documento existente é quase sempre mais barato do que criar o seu próprio.
- Para prompts técnicos longos, tente o inglês. Não é apenas uma questão de preço: os modelos aprenderam principalmente com textos em inglês e seguem um briefing em inglês com mais precisão.
As ressalvas, sem as quais os números mentem
Medimos um modelo — Gemini 2.5 Flash-Lite — em uma nuvem. Modelos mais poderosos custam várias vezes mais; concorrentes têm suas próprias listas de preços. O que se mantém em todo lugar é a ordem de magnitude e, mais importante, a proporção entre as operações: entrada é mais barata que saída, ler é mais barato que criar.
Segundo: as tarifas mudam. Nossos números são de 30 de julho de 2026. Verifique o preço na página de preços do próprio fornecedor, e não em artigos — incluindo este.
FAQ
Quanto custa um pedido de ChatGPT ou Gemini para um usuário comum?
Se você usa uma interface de chat por assinatura, nada além da assinatura — os limites são contados em pedidos, não em dinheiro. Os valores neste artigo se aplicam ao acesso via API, onde uma IA é integrada ao seu próprio software e você paga por token: $0,0003 por uma pergunta de texto, $0,001 para ler uma foto, $0,04 por uma imagem gerada.
Por que gerar uma imagem custa mais que ler dez fotos?
Porque são operações de tipos diferentes. Ler uma imagem significa enviá-la como entrada, e tokens de entrada são a coisa mais barata da lista. Criar uma imagem significa produzir saída, que é cobrada separadamente e muito mais cara. Em nossas medições, uma imagem gerada custa $0,04, enquanto ler uma foto custa $0,001 — quarenta vezes menos.
Quanto custa para uma IA analisar um vídeo do YouTube?
Medido em 30 de julho de 2026 com Gemini 2.5 Flash-Lite: 258 tokens por segundo de filmagem mais 25 tokens por segundo de áudio. Um clipe de dez minutos chega a cerca de 171.000 tokens, aproximadamente $0,02. Uma hora de vídeo custa cerca de doze centavos.
É verdade que a geração de vídeo custa dólares por segundo?
Sim. O Veo 3.1 é cobrado por segundo: $0,40 por segundo no modo padrão e a partir de $0,05 no nível lite. Um clipe de oito segundos custa $3,20 no modo padrão — mais do que analisar cento e cinquenta horas do vídeo de outra pessoa.
Como cortar custos de IA sem perder qualidade?
Três hábitos fazem a maior parte do trabalho. Primeiro, limite explicitamente o tamanho da resposta, pois tokens de saída custam quatro vezes mais que os de entrada. Segundo, comece um novo chat para uma nova tarefa — todo o histórico é reenviado a cada mensagem. Terceiro, não gere o que você pode encontrar e ler.
Por que o texto em algumas línguas custa mais que em inglês?
O modelo não conta letras nem palavras, mas tokens — pedaços de texto. O inglês se divide em blocos maiores: cerca de quatro caracteres por token, contra aproximadamente dois em muitas outras línguas. A mesma ideia demanda de uma vez e meia a duas vezes mais tokens, e custa proporcionalmente mais.
Onde posso ver quantos tokens minha requisição usou?
A resposta da API contém um bloco `usageMetadata` onde o modelo informa as contagens de tokens de entrada e saída, detalhadas por modalidade: texto, imagem, vídeo, áudio. Todos os dados neste artigo vieram de lá, e você pode repetir a medição em suas próprias requisições.